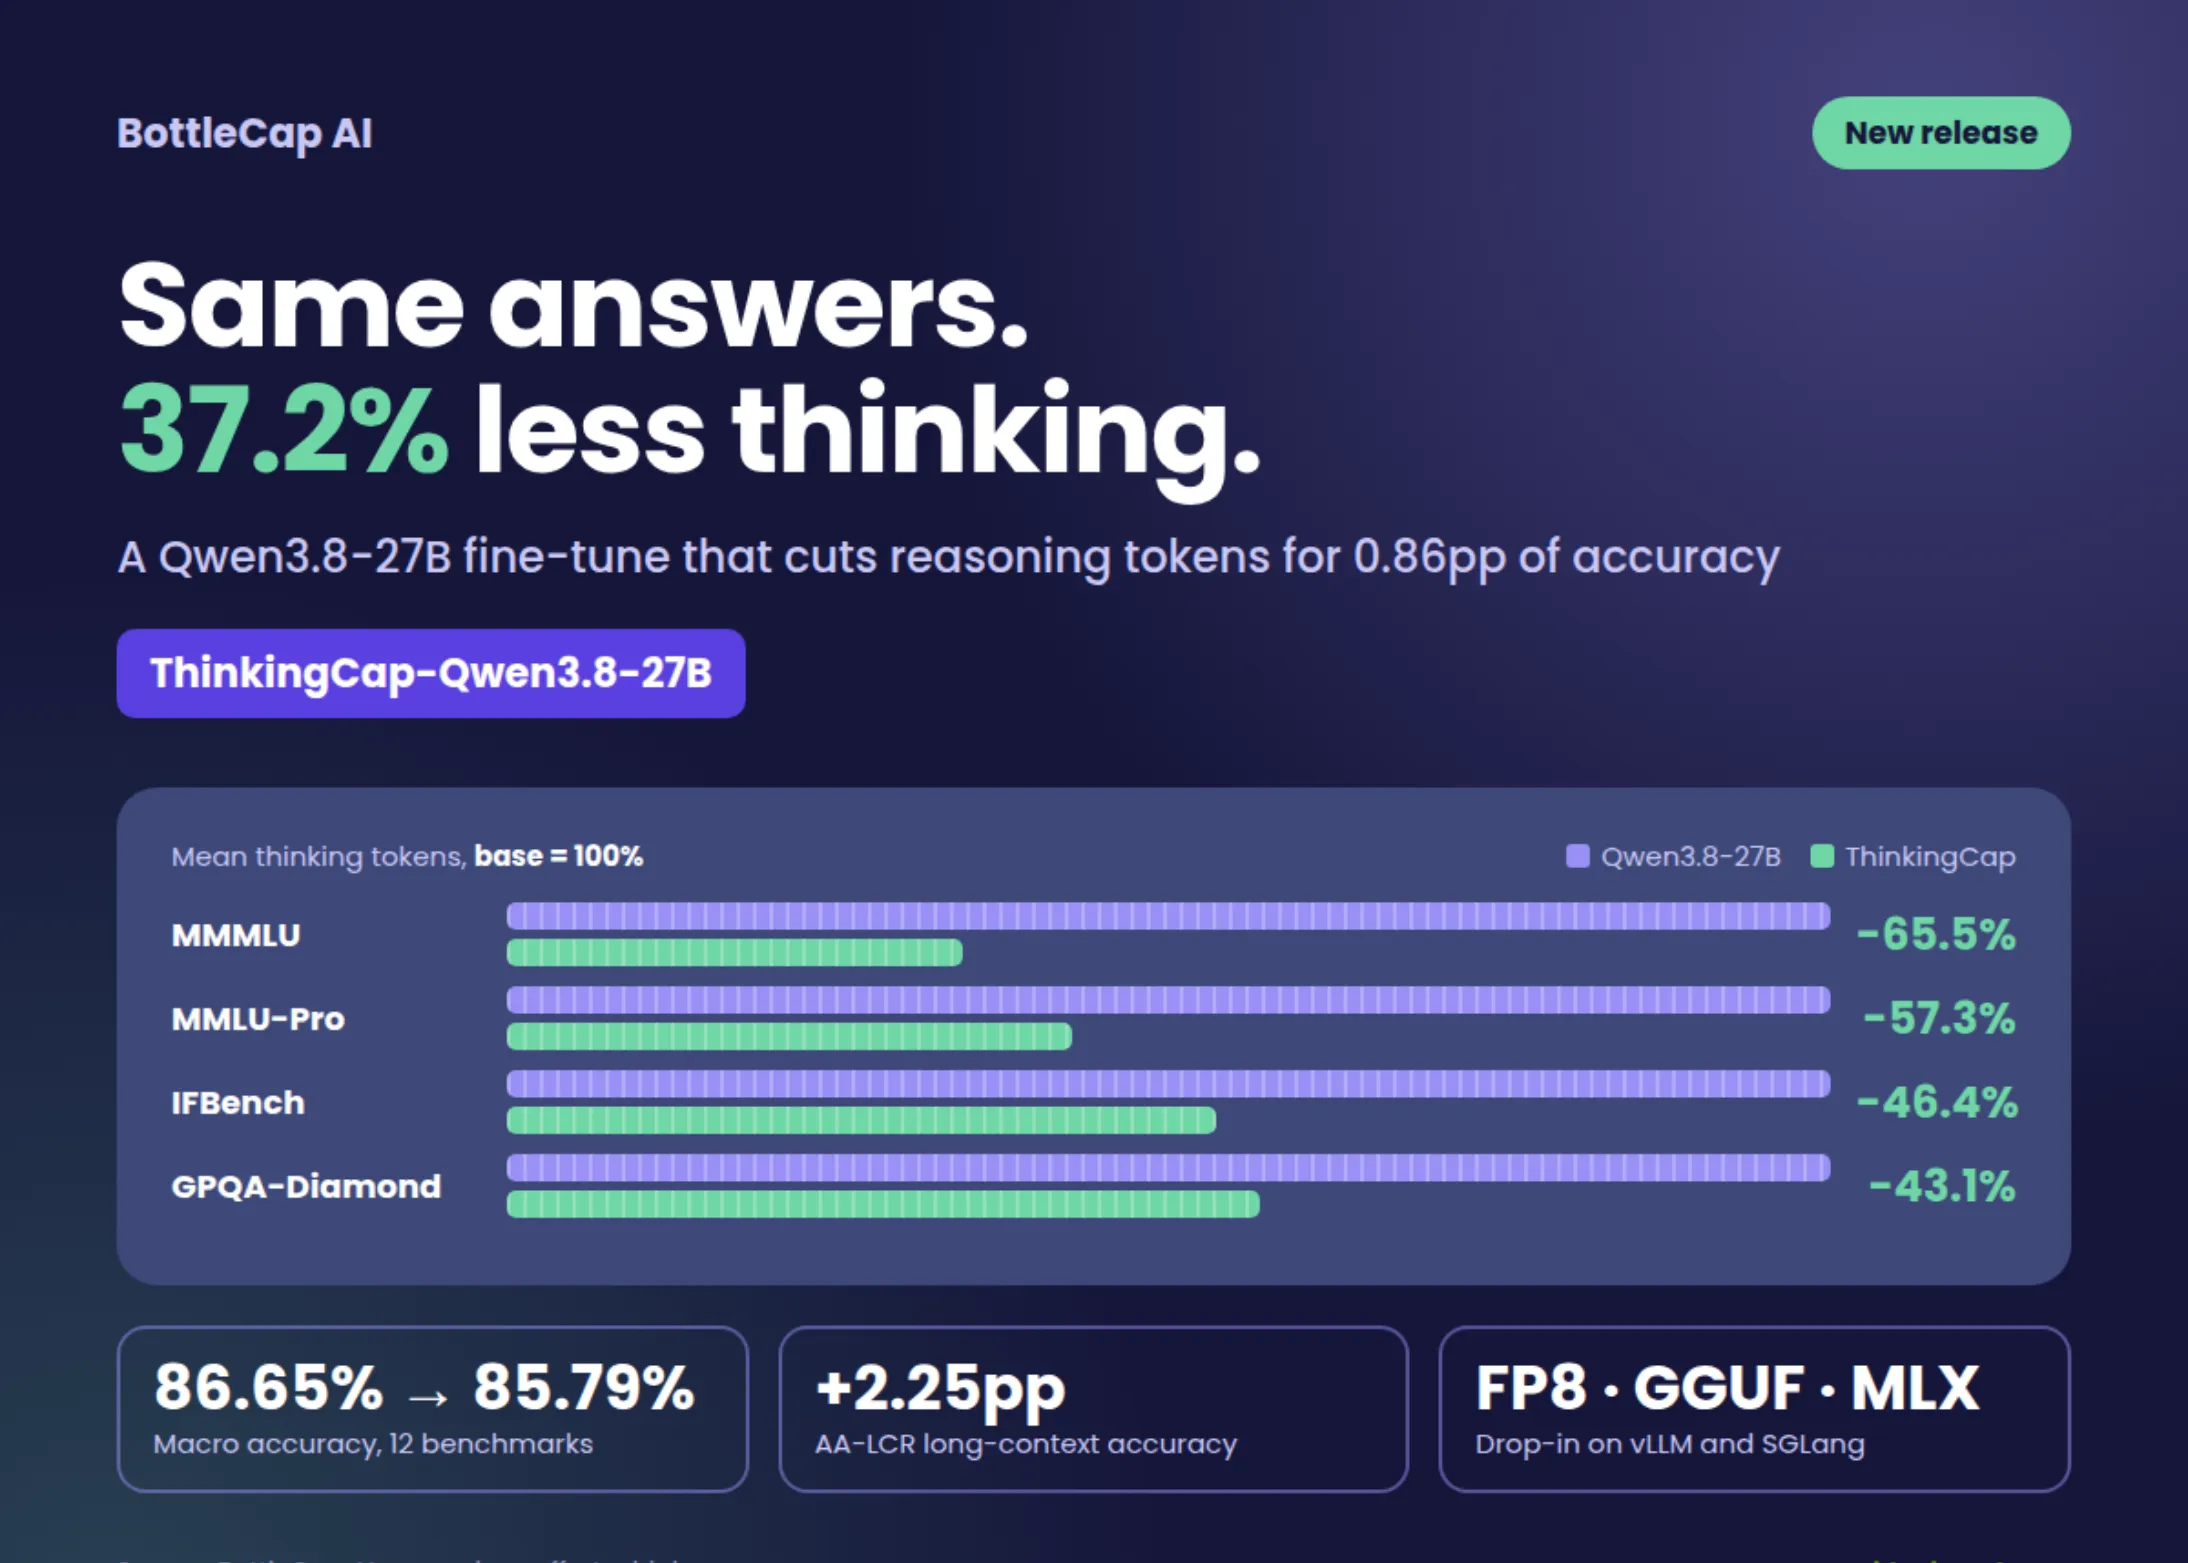
최근 AI 기술 분야에서 모델 효율성, 오디오 생성 기능, 엣지 디바이스 적용 가능성 증대가 관측됐다. 보틀캡 AI는 추론 토큰 사용량을 평균 37.2% 절감한 ‘ThinkingCap-Qwen3.8-27B’를 출시했으며, 구글은 표현력 높은 ‘Gemini 3.8 Flash TTS’ 및 ‘Flash-Lite TTS’ 모델을 선보였다. 프리즘ML은 퀄컴 스냅드래곤 플랫폼에서 구동되는 20억 파라미터 규모의 ‘1-bit Bonsai LLM’을 공개하며 엣지 AI의 잠재력을 시사했다.
핵심 기술 사양 및 성능 비교
각사의 신규 모델은 특정 목표에 맞춰 최적화된 성능 지표를 제시했다.
- 보틀캡 AI ThinkingCap-Qwen3.8-27B: 12개 벤치마크에서 평균 37.2%의 추론 토큰 감소를 기록했다. 거시 평균 정확도는 86.65%에서 85.79%로 0.86%p 하락했으나, AA-LCR 벤치마크에서는 정확도가 81.75%에서 84.00%로 2.25%p 상승하며 추론 토큰을 38.6% 절감했다. AIME 2026 벤치마크에서는 98.13%에서 94.27%로 3.85%p의 정확도 하락이 발생했으나, 추론 토큰은 30.2% 감소했다.
- 구글 Gemini 3.8 Flash TTS 및 Flash-Lite TTS: Flash TTS는 창의적 방향 및 캐릭터 음성에 특화되었으며, Flash-Lite TTS는 고용량, 비용 효율적 제작에 초점을 맞췄다. 두 모델 모두 100개 이상의 언어 및 방언에서 프롬프트 기반의 생성형 음성 디자인을 지원하며, 2,000개 이상의 생산 준비 완료 음성을 제공한다.
- 프리즘ML 1-bit Bonsai LLM: 20억 개 파라미터 규모의 비전-언어 모델로, 기존 모델 대비 4배 크기 감소를 달성했다. 이 모델은 퀄컴 스냅드래곤 AR1 Gen 1 플랫폼 기반 스마트 안경에서 로컬 구동된다.
산업 및 비즈니스 파급 효과
이번 신기술 발표는 AI 도입 및 활용 전략에 유의미한 시사점을 제공한다.
보틀캡 AI의 ThinkingCap 모델은 대규모 언어 모델(LLM)의 추론 효율성을 개선하여 잠재적으로 운영 비용을 절감하고, 토큰 예산이 제한된 환경에서 성능을 최적화할 수 있는 가능성을 제시한다. 이는 클라우드 기반 AI 서비스의 비용 구조에 영향을 미칠 수 있다.
구글의 Gemini 3.8 Flash TTS 시리즈는 엔터테인먼트, 콘텐츠 제작 및 광고 산업에서 고품질의 표현력 있는 오디오 콘텐츠를 대규모로 생성하는 데 기여할 것으로 분석된다. 100개 이상의 언어 및 2,000개 이상의 음성 지원은 글로벌 시장에서의 서비스 확장성을 강화한다.
프리즘ML의 1-bit Bonsai LLM은 스마트 안경과 같은 엣지 디바이스에서 LLM을 로컬로 구동하며 실시간 응답 및 향상된 개인정보 보호를 가능하게 한다. 이는 클라우드 의존도를 줄이고 증강현실(AR) 및 웨어러블 기기 시장에서 새로운 AI 기반 애플리케이션 개발을 가속화할 전망이다.