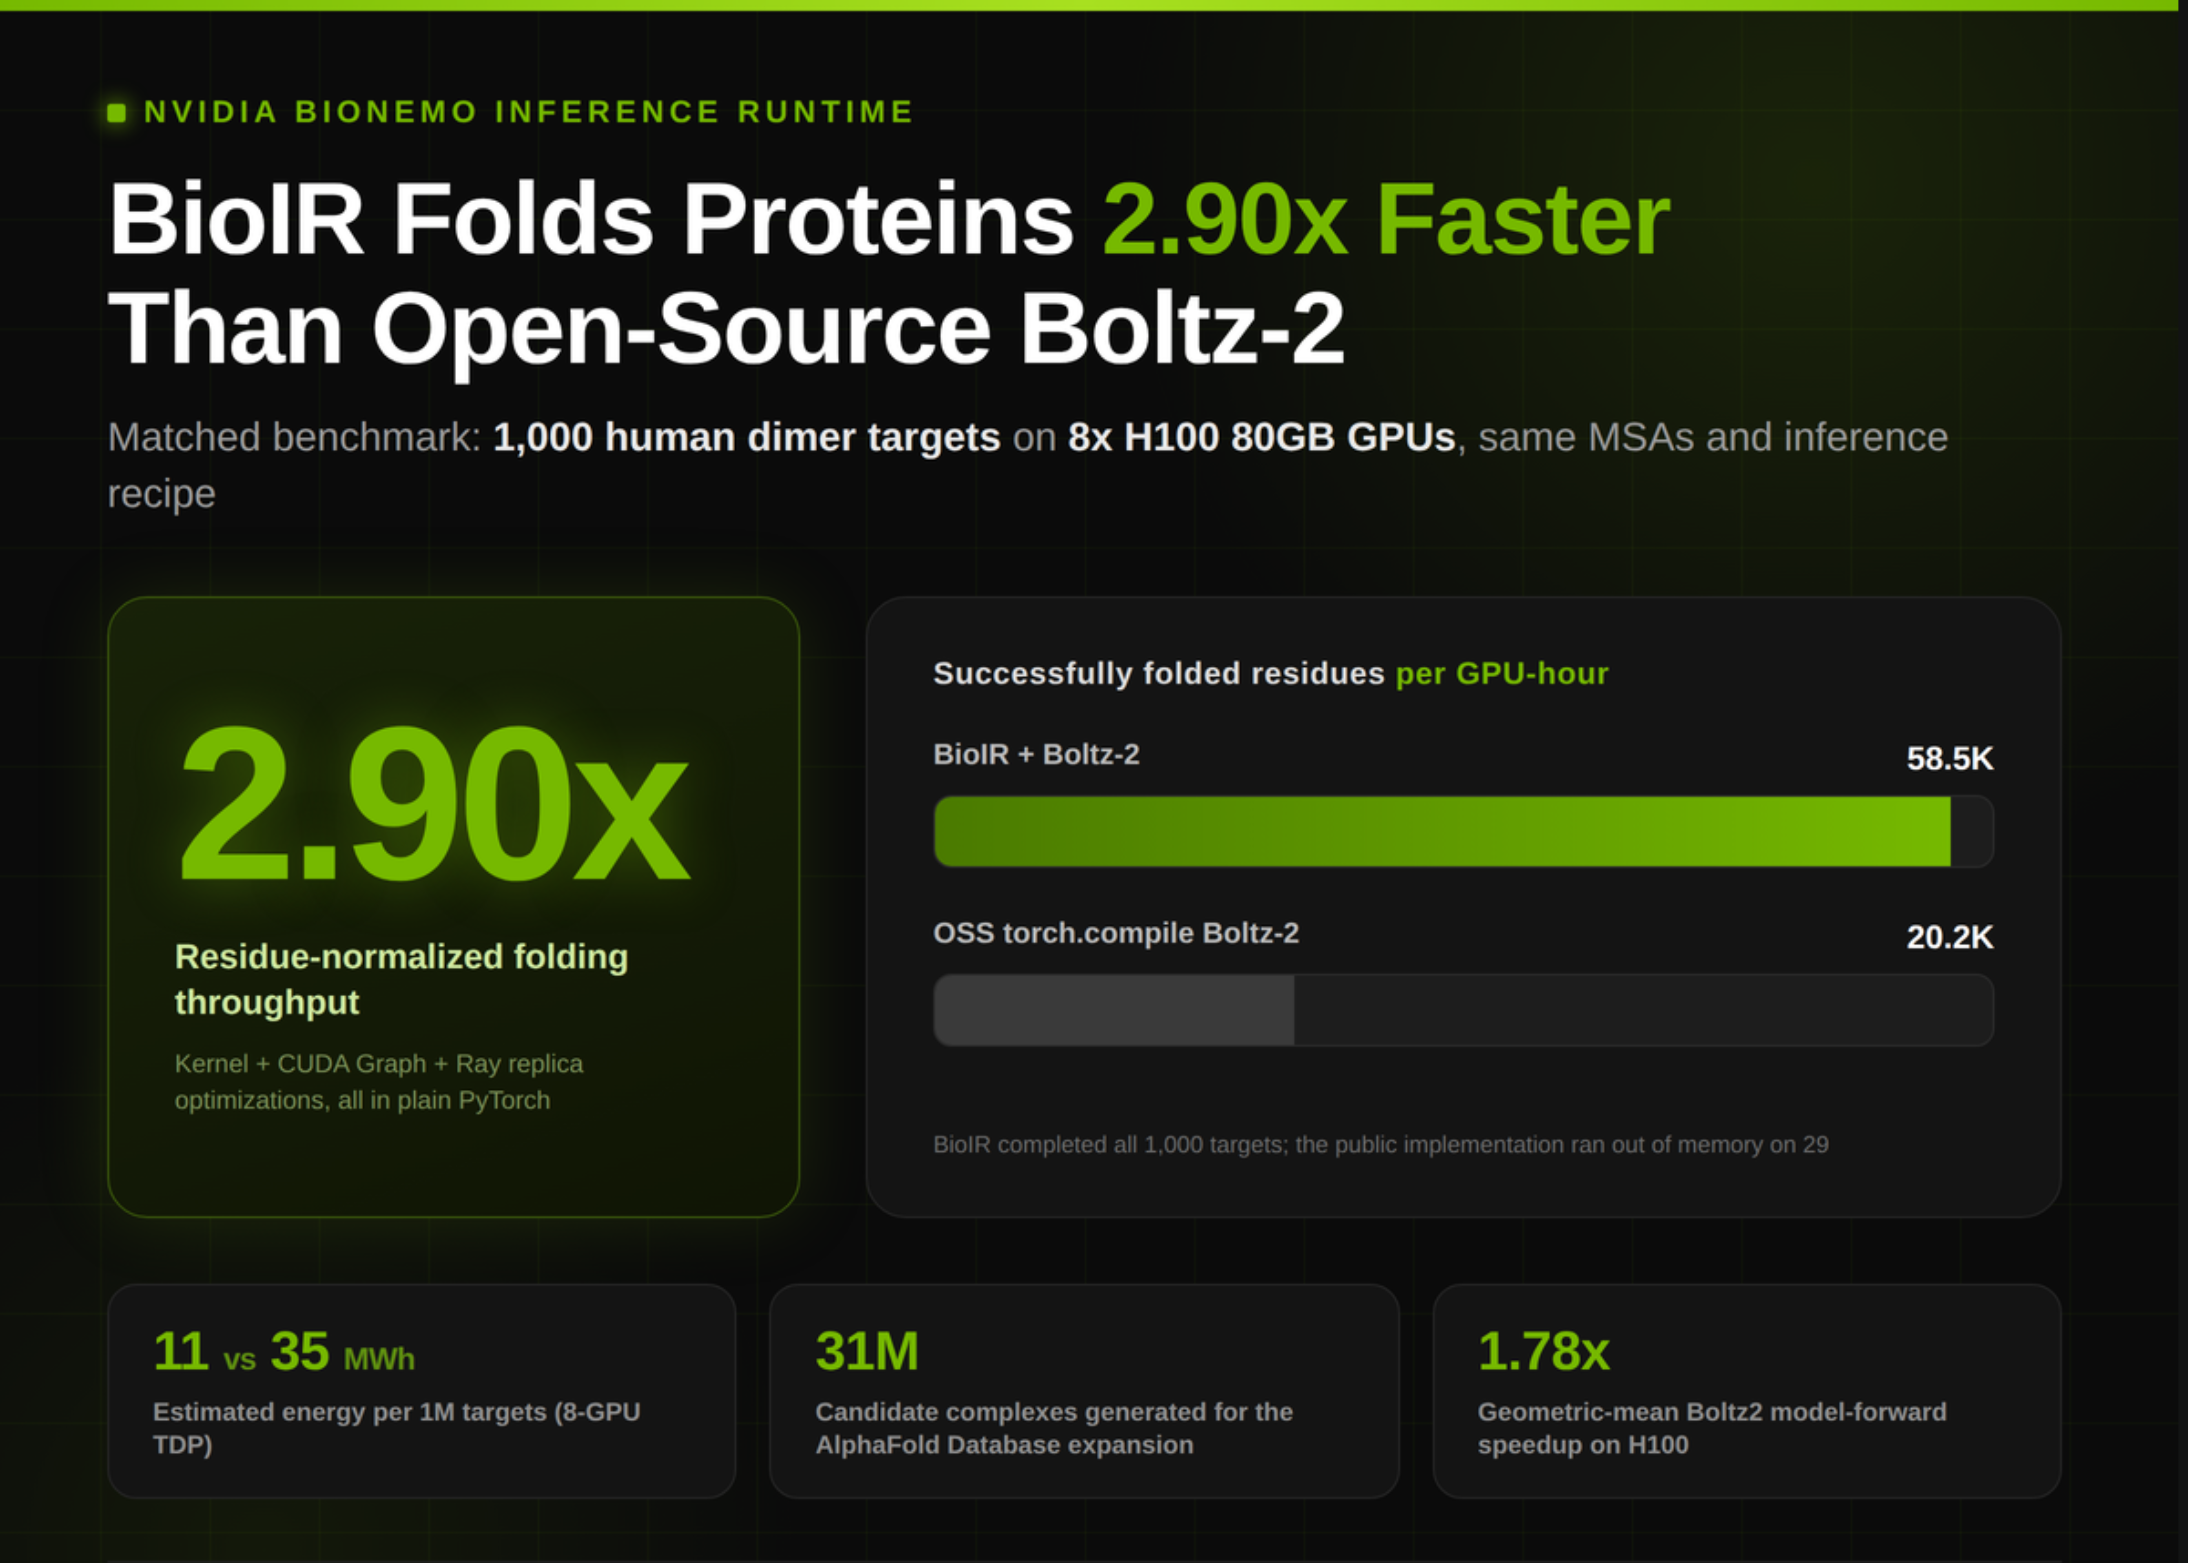
NVIDIA가 생체 분자 구조 예측 워크플로우 가속화를 위한 BioNeMo Inference Runtime (BioIR) 라이브러리를 공개했다. 동시에 Redis는 대규모 언어 모델(LLM) 애플리케이션의 비용 및 응답 속도를 최적화하는 LangCache를 선보이며 AI 모델 배포 및 운영 효율성 증대에 중점을 둔 솔루션들을 제시했다.
핵심 기술 사양 및 성능 분석
NVIDIA BioNeMo Inference Runtime (BioIR)은 단일 타겟을 넘어 프로테옴 규모의 생체 분자 구조 예측 작업 병목 현상을 해결한다. 이는 파싱, 피처링, GPU 추론, 출력 기록 전반을 가속한다. BioIR은 표준 PyTorch 워크플로우를 유지하면서도 Pairformer 및 Evoformer 스택, 삼각형 연산, 쌍별 어텐션, 확산 트랜스포머 등 일반적인 추론 스택에서 최적화되지 않은 작업을 타겟팅한다. 가속화는 커널 선택 및 모듈 최적화의 3단계 계층으로 이루어진다. BioIR은 Python 3.12+, 호환 NVIDIA GPU 및 드라이버, A3M MSA를 필요로 하며, nvcc, CUDA 소스, CMake, CUDA 툴킷 설치는 요구되지 않는다.
- AlphaFold 데이터베이스 확장 기여: BioIR은 AlphaFold 데이터베이스 확장에 활용되어 4,777개 프로테옴에 걸쳐 단백질 복합체 구조를 생성했다.
- 후보 복합체 식별 수: 약 3,100만 개의 후보 복합체 식별을 지원했다.
- 고신뢰도 예측 결과: 이 중 181만 개의 복합체가 고신뢰도 예측으로 공개되었다.
Redis LangCache는 LLM 기반 애플리케이션에서 의미는 같으나 표현이 다른 반복적인 질문으로 인한 불필요한 전체 LLM 호출을 방지하는 시맨틱 캐싱 서비스이다. 이 서비스는 애플리케이션과 LLM 사이에 위치하여, 들어오는 프롬프트에 대한 임베딩을 생성하고 이전에 답변된 프롬프트와 의미론적 유사성을 기반으로 매칭한다. 캐시 적중 시 저장된 응답을 반환하며 LLM 호출을 회피한다. 캐시 미스 발생 시에는 LLM을 호출한 후 프롬프트와 새 응답을 저장하는 방식으로 동작한다.
- LLM API 비용 절감: Redis는 LangCache를 통해 LLM API 비용을 최대 90%까지 절감할 수 있다고 보고했다.
- 캐시 적중 응답 속도: 캐시 적중 시 LLM 재질의 대비 최대 15배 빠른 응답 속도를 제공한다.
산업 및 비즈니스 파급 효과
NVIDIA BioIR은 생명과학 및 제약 연구 분야에서 단백질 구조 예측의 처리량을 기하급수적으로 증대시켜 신약 개발 및 생체 메커니즘 이해에 필수적인 데이터 확보 속도를 높인다. 이는 연구 비용과 시간을 절감하는 직접적인 효과로 이어지며, GPU 기반 가속은 대규모 컴퓨팅 자원 활용 효율성을 극대화하여 기존에는 비현실적이었던 규모의 연구를 가능하게 한다.
Redis LangCache는 고객 지원 및 정보 검색(RAG) 파이프라인 등 LLM 기반 서비스의 운영 비용을 혁신적으로 절감한다. 유사 질문에 대한 반복적인 LLM 호출을 줄여 토큰 소비를 최소화하고, 응답 지연을 대폭 단축하여 사용자 경험을 개선한다. 이는 서비스 제공자의 재정적 부담을 줄이고 AI 서비스의 상용화 및 확장성을 강화하는 중요한 요소로 작용한다.