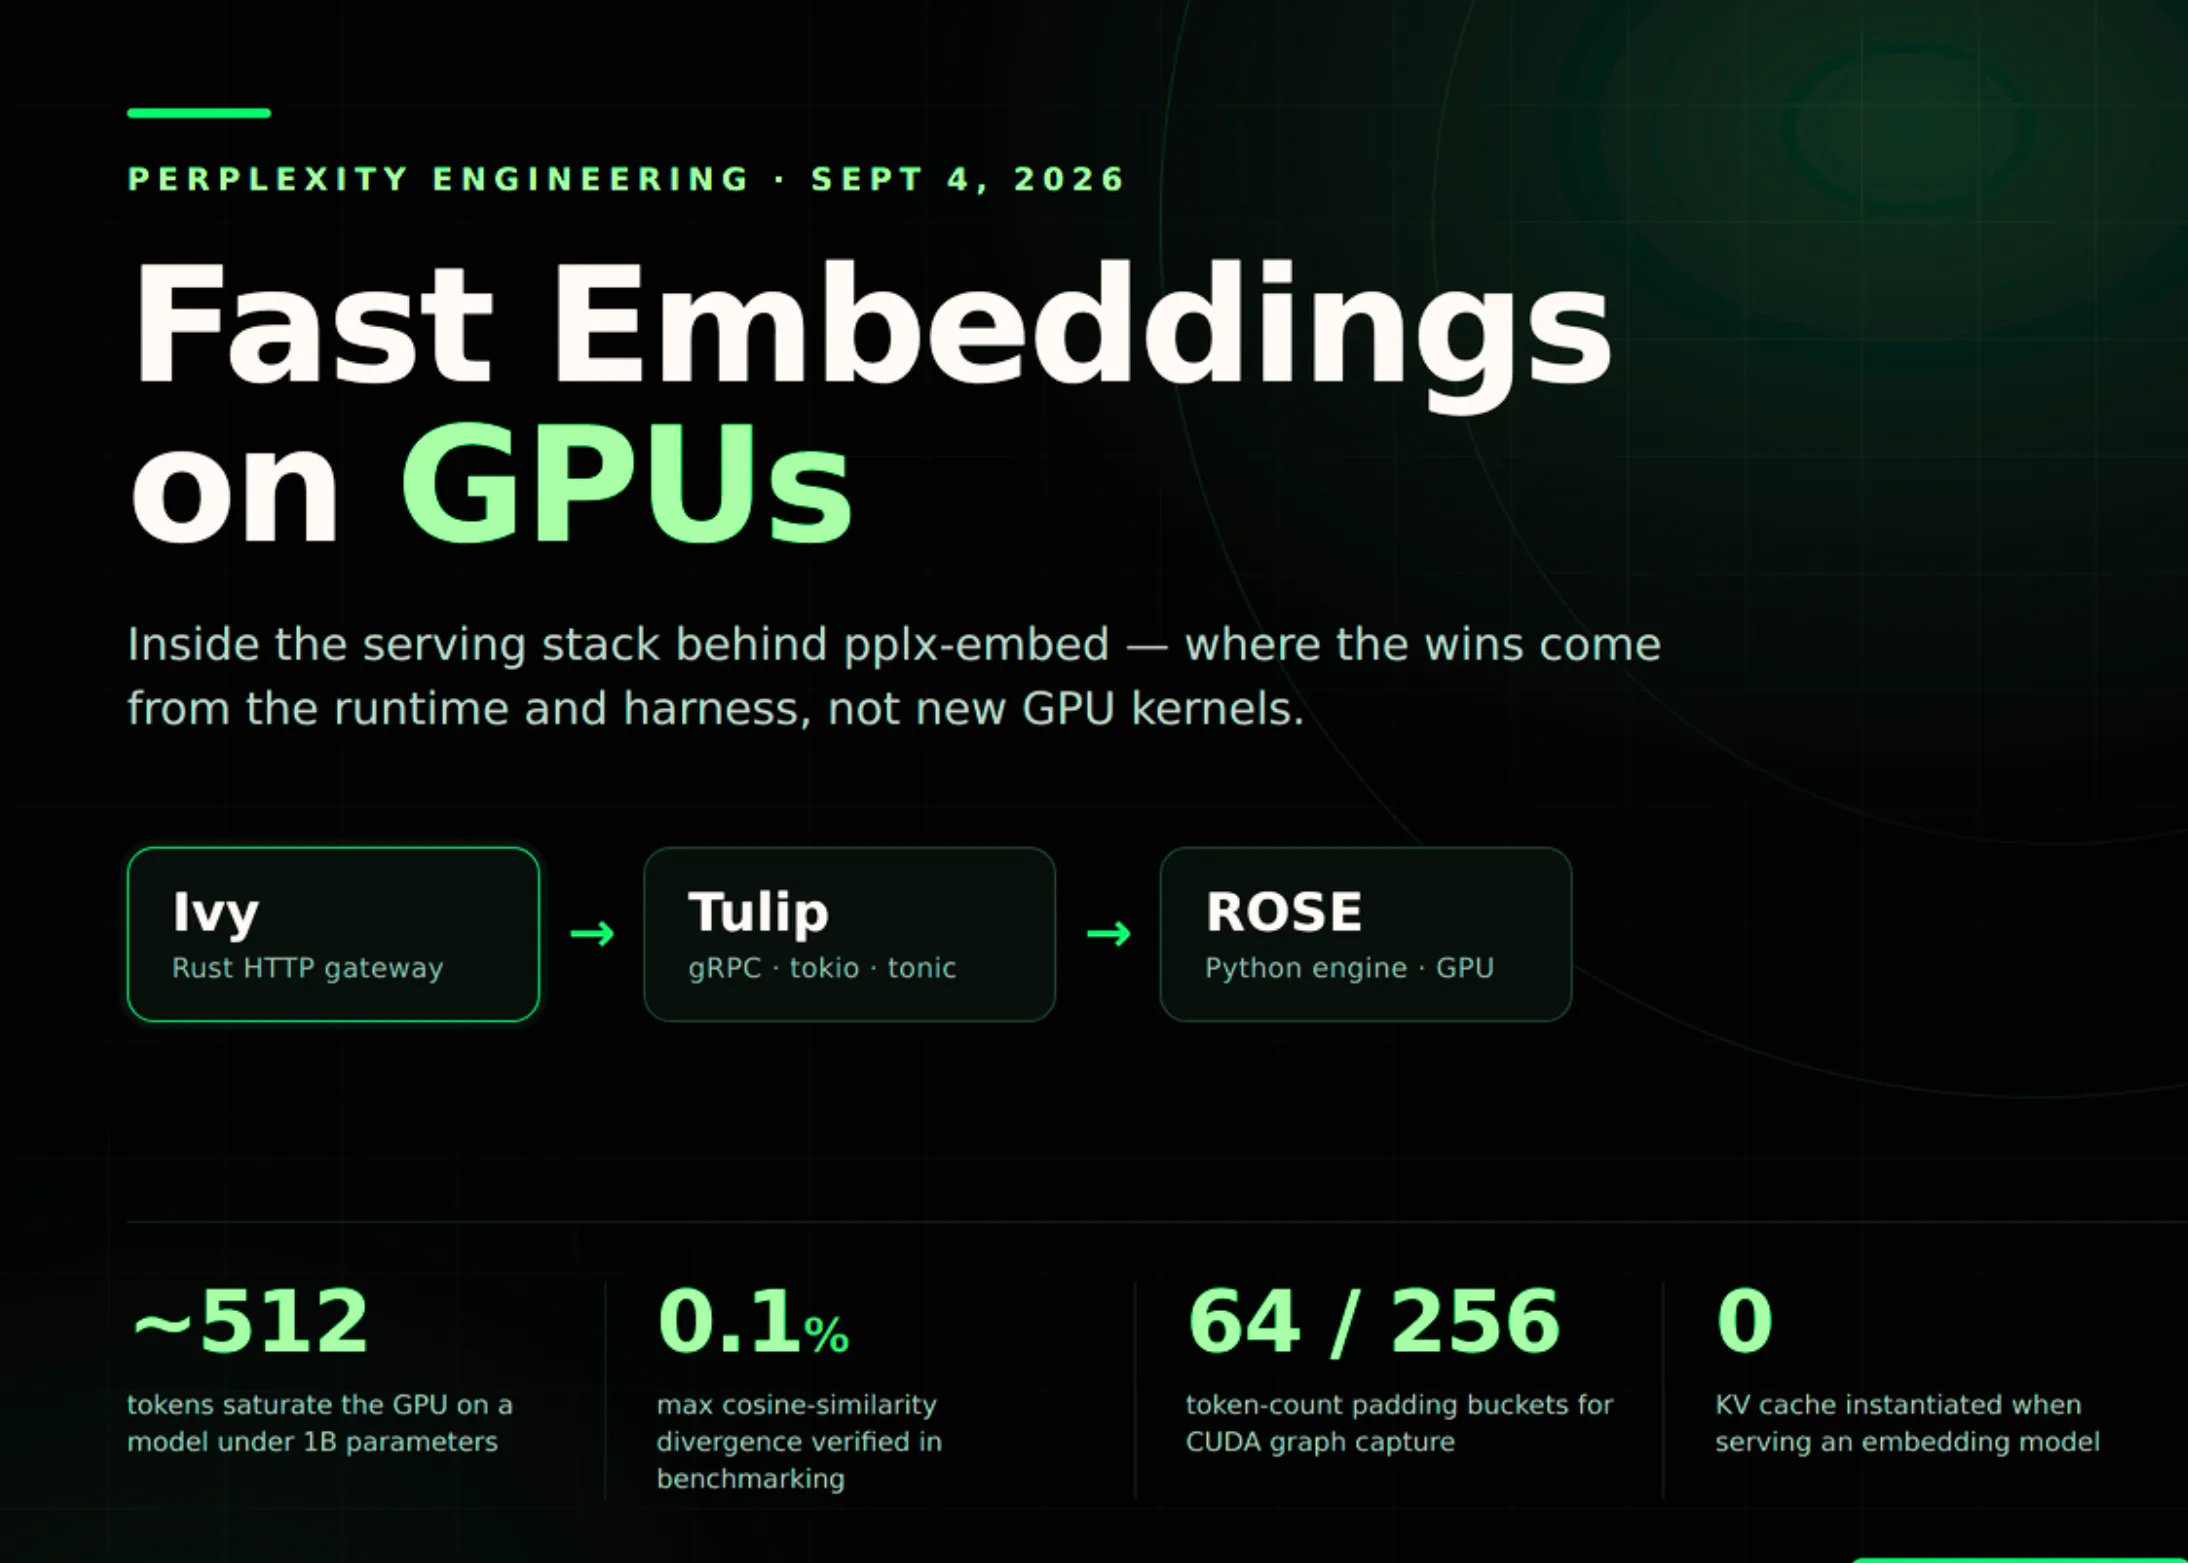
Perplexity Engineering 팀은 GPU 기반 임베딩 추론 시스템의 최적화 성과를 공개했다. 이 시스템은 AI 검색 제품의 핵심인 벡터 데이터베이스 구축과 쿼리 시점 임베딩 처리의 효율성 및 비용 절감을 목표로 한다. 특히, 대규모 언어 모델(LLM) 스택의 기존 커널을 재활용하고 독자적인 서비스 아키텍처를 도입하여 성능을 향상했다.
핵심 기술 사양 및 아키텍처
Perplexity는 두 가지 주요 임베딩 워크로드(배치 임베딩 및 온라인 임베딩)를 단일 엔진으로 처리한다. 임베딩 모델의 특성을 활용하여 LLM 스택의 Prefill 및 Decode 커널을 재사용한다.
- 엔진 통합: 소형 트랜스포머 기반 임베딩 모델을 위해 LLM 스택의 Prefill 및 Decode 커널을 재사용, 연산 및 메모리 바운드 워크로드를 효율적으로 처리한다.
- Ivy (HTTP 게이트웨이): Rust 기반으로 JSON 파싱, 토큰화, 인풋 템플릿 처리, 배치 분할 등 CPU 작업을 수행한다. 요청을 gRPC 프로토콜로 변환하고 대규모 요청을 분할하여 레플리카 간 부하를 분산한다.
- Tulip (추론 서버 인터페이스): Rust, Tokio, Tonic으로 구축된 gRPC 서버로, 스케줄링 및 배치 처리를 담당하며 엔진으로 요청을 디스패치한다.
- ROSE (Runtime-Optimized Serving Engine): 모델 추론을 구현하는 엔진으로, CUDA 그래프 관리, 비동기 결과 추적 추상화, Rust 요청 경로를 활용하여 런타임 성능을 최적화한다.
산업적 시사점 및 비용 효율성
Perplexity의 최적화된 임베딩 시스템은 AI 검색 분야 전반에 걸쳐 실질적인 이점을 제공한다.
- 비용 효율성 증대: 벡터 데이터베이스 구축 및 재색인 시 발생하는 배치 임베딩은 처리량 극대화를 통해 운영 비용을 최소화한다.
- 실시간 성능 향상: 쿼리 시점 임베딩은 짧은 쿼리에 대한 빠른 처리 속도를 보장하여 사용자 경험을 개선하고 AI 검색의 즉각성을 높인다.
- 자원 활용 최적화: 단일화된 엔진이 다양한 컴퓨팅 워크로드를 효율적으로 처리함으로써 GPU 자원 활용도를 높여 인프라 투자 대비 효율성을 극대화한다.
- 검색 품질 개선: 향상된 임베딩 추론 능력은 AI 검색 제품의 핵심 지표인 검색 품질(Retrieval Quality)을 직접적으로 개선하여 사용자 만족도를 높인다.