AI 모델 최적화 및 안전성: 구글 R4T, 워터마킹 동향, 다국어 벤치마크
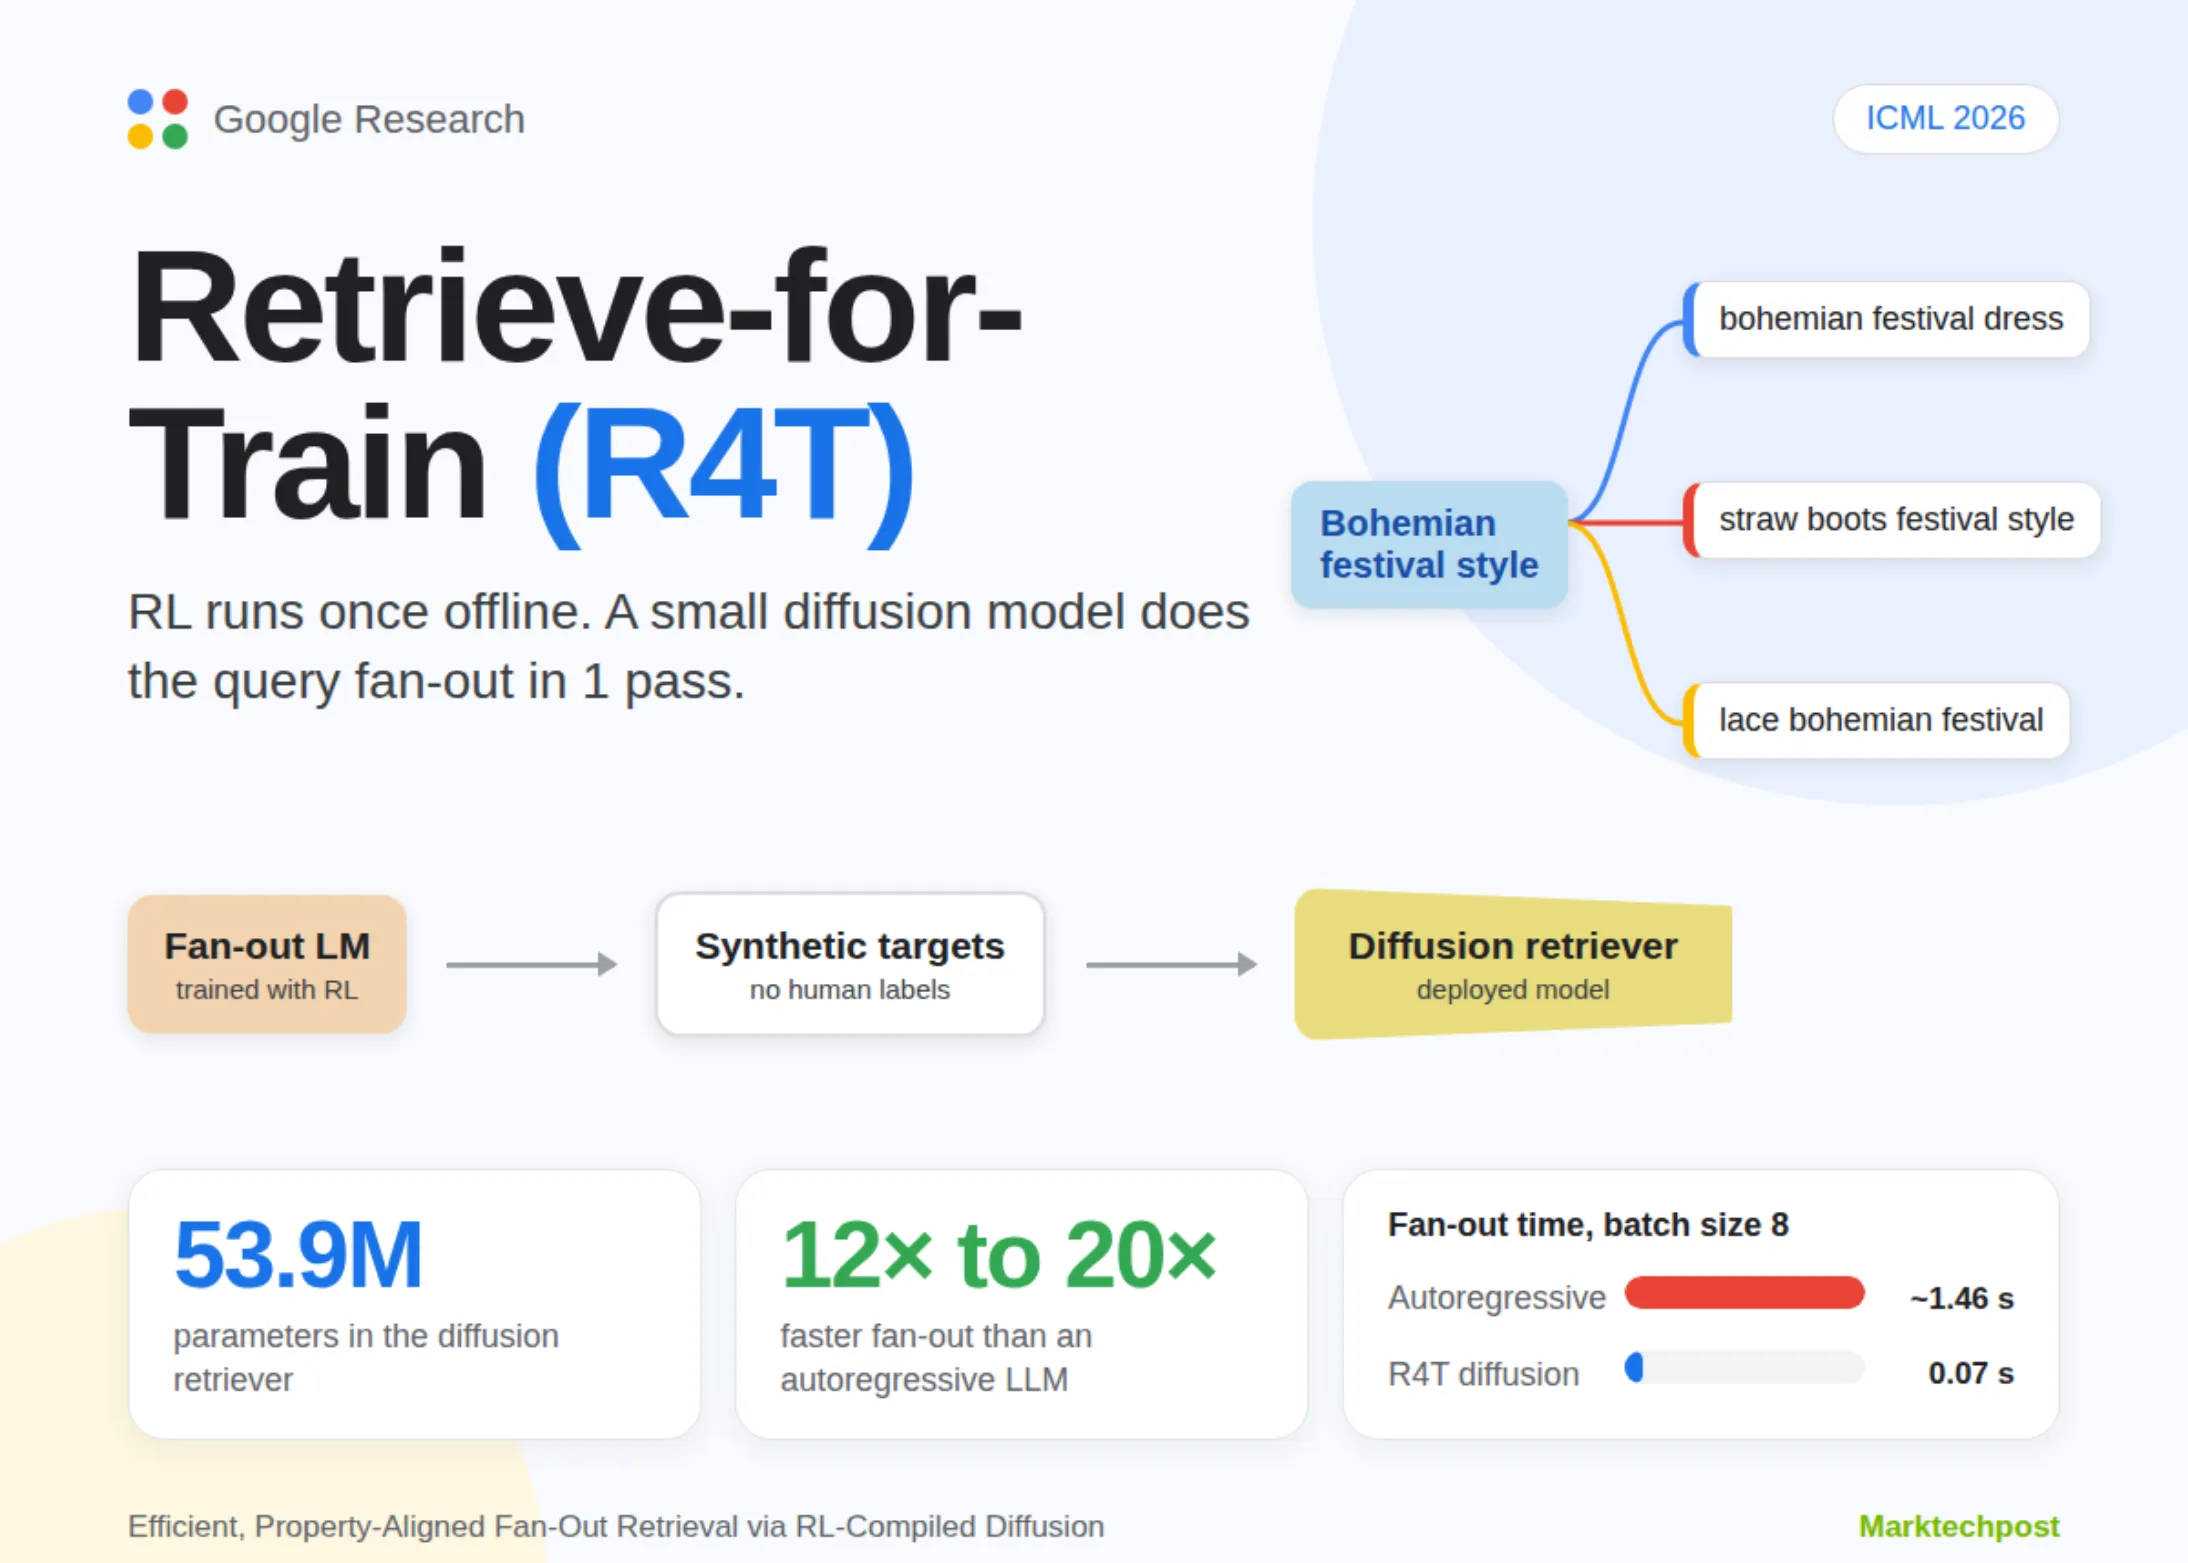
구글 리서치는 광범위한 검색 및 추천 시스템의 결과 다양성을 높이는 ‘Retrieve-for-Train(R4T)’ 프레임워크를 공개했다. 한편, 앤스로픽은 구글의 ‘SynthID-Text’ 워터마킹 기술을 클로드 모델에 적용할 계획을 발표했으며, 이 기술이 모델의 안전 장치에 미칠 수 있는 영향이 연구를 통해 드러났다. 스케일 AI는 한국 AI 안전 연구소와 협력하여 다국어 LLM 안전성 벤치마크 ‘ROK-FORTRESS’를 발표하며 한국어 프롬프트가 영어 대비 낮은 유해성을 … 더 읽기
Anthropic, AI 에이전트 위험 경고 및 규제 촉구… Nunchux AI, 비디오 DiTs 연산 효율성 개선

Anthropic CEO 다리오 아모데이(Dario Amodei)는 AI 에이전트의 급속한 발전이 6~12개월 내 인터넷 장악 및 수백억 달러의 피해를 초래할 수 있다고 경고하며, AI 개발 속도 조절과 정부 규제의 필요성을 강조했습니다. 동시에 Nunchux AI는 비디오 Diffusion Transformers (DiTs)의 핵심 연산 병목을 해결하는 VC-Attention 커널을 공개하며 AI 효율성 개선 방안을 제시했습니다. 핵심 기술 사양 및 성능 비교 Nunchux … 더 읽기

구글, 제미니 3.8 모델 공개 및 메타, WhatsApp 비즈니스 AI 도입: 대중적 AI 인프라 반대 직면

구글은 2026년 9월 15일 제미니 3.8 라이브 및 확장형 사고 모델을 발표하며 대화형 AI 역량을 강화했다. 메타는 새로운 MCP 서버를 통해 AI 에이전트가 WhatsApp 비즈니스 메시징 설정을 관리하도록 지원한다. 동시에, 최근 여론조사에서는 AI 기술 및 관련 데이터센터 건설에 대한 대중의 부정적 인식이 확산되는 것으로 확인되었다. 핵심 기술 사양 및 성능 분석 구글의 제미니 3.8 라이브 … 더 읽기

주요 AI 기업, 개발 속도 조절 및 독립 평가자 도입 합의: ‘재귀적 자율 개선’과 ‘에이전트 군집’ 사고 촉발

2026년 9월 12일, Anthropic CEO 다리오 아모데이(Dario Amodei)는 AI 모델 개발 속도를 늦출 것을 촉구하는 에세이 ‘우리는 선두의 속도를 조절해야 한다(We Must Pace the Frontier)’를 발표했다. 해당 메시지는 Sam Altman(OpenAI)과 Elon Musk(xAI)의 즉각적인 지지를 받았으며, 다음 날 Microsoft CEO 사티아 나델라(Satya Nadella)도 ‘신중한 속도 조절’과 ‘내장된 평가자’ 도입을 환영했다. 아모데이 CEO의 발표 게시물은 9월 13일까지 … 더 읽기

선도 AI 기업, 개발 속도 조절 및 외부 안전 평가 도입 촉구… 초파리 커넥톰 모델 성능 공개

앤스로픽(Anthropic) CEO 다리오 아모데이(Dario Amodei)는 AI 개발 속도를 늦춰 안전장치 구축 및 규제 평가 시간을 확보해야 한다고 주장하며, 제3자 평가 기관에 모델 접근권을 부여하는 계획을 발표했습니다. 이와 동시에, 초파리 뇌 커넥톰을 활용한 새로운 ‘초파리 언어 모델(FLM)’이 개발되었으나, 표준 모델 대비 성능 향상을 입증하지 못했습니다. 핵심 기술 사양 및 성능 분석: 초파리 언어 모델(FLM) 초파리 언어 … 더 읽기

LLM 툴 호출 효율 개선 및 AI 에이전트 자율성 확대, 메타 AI 코딩 앱으로 대중화

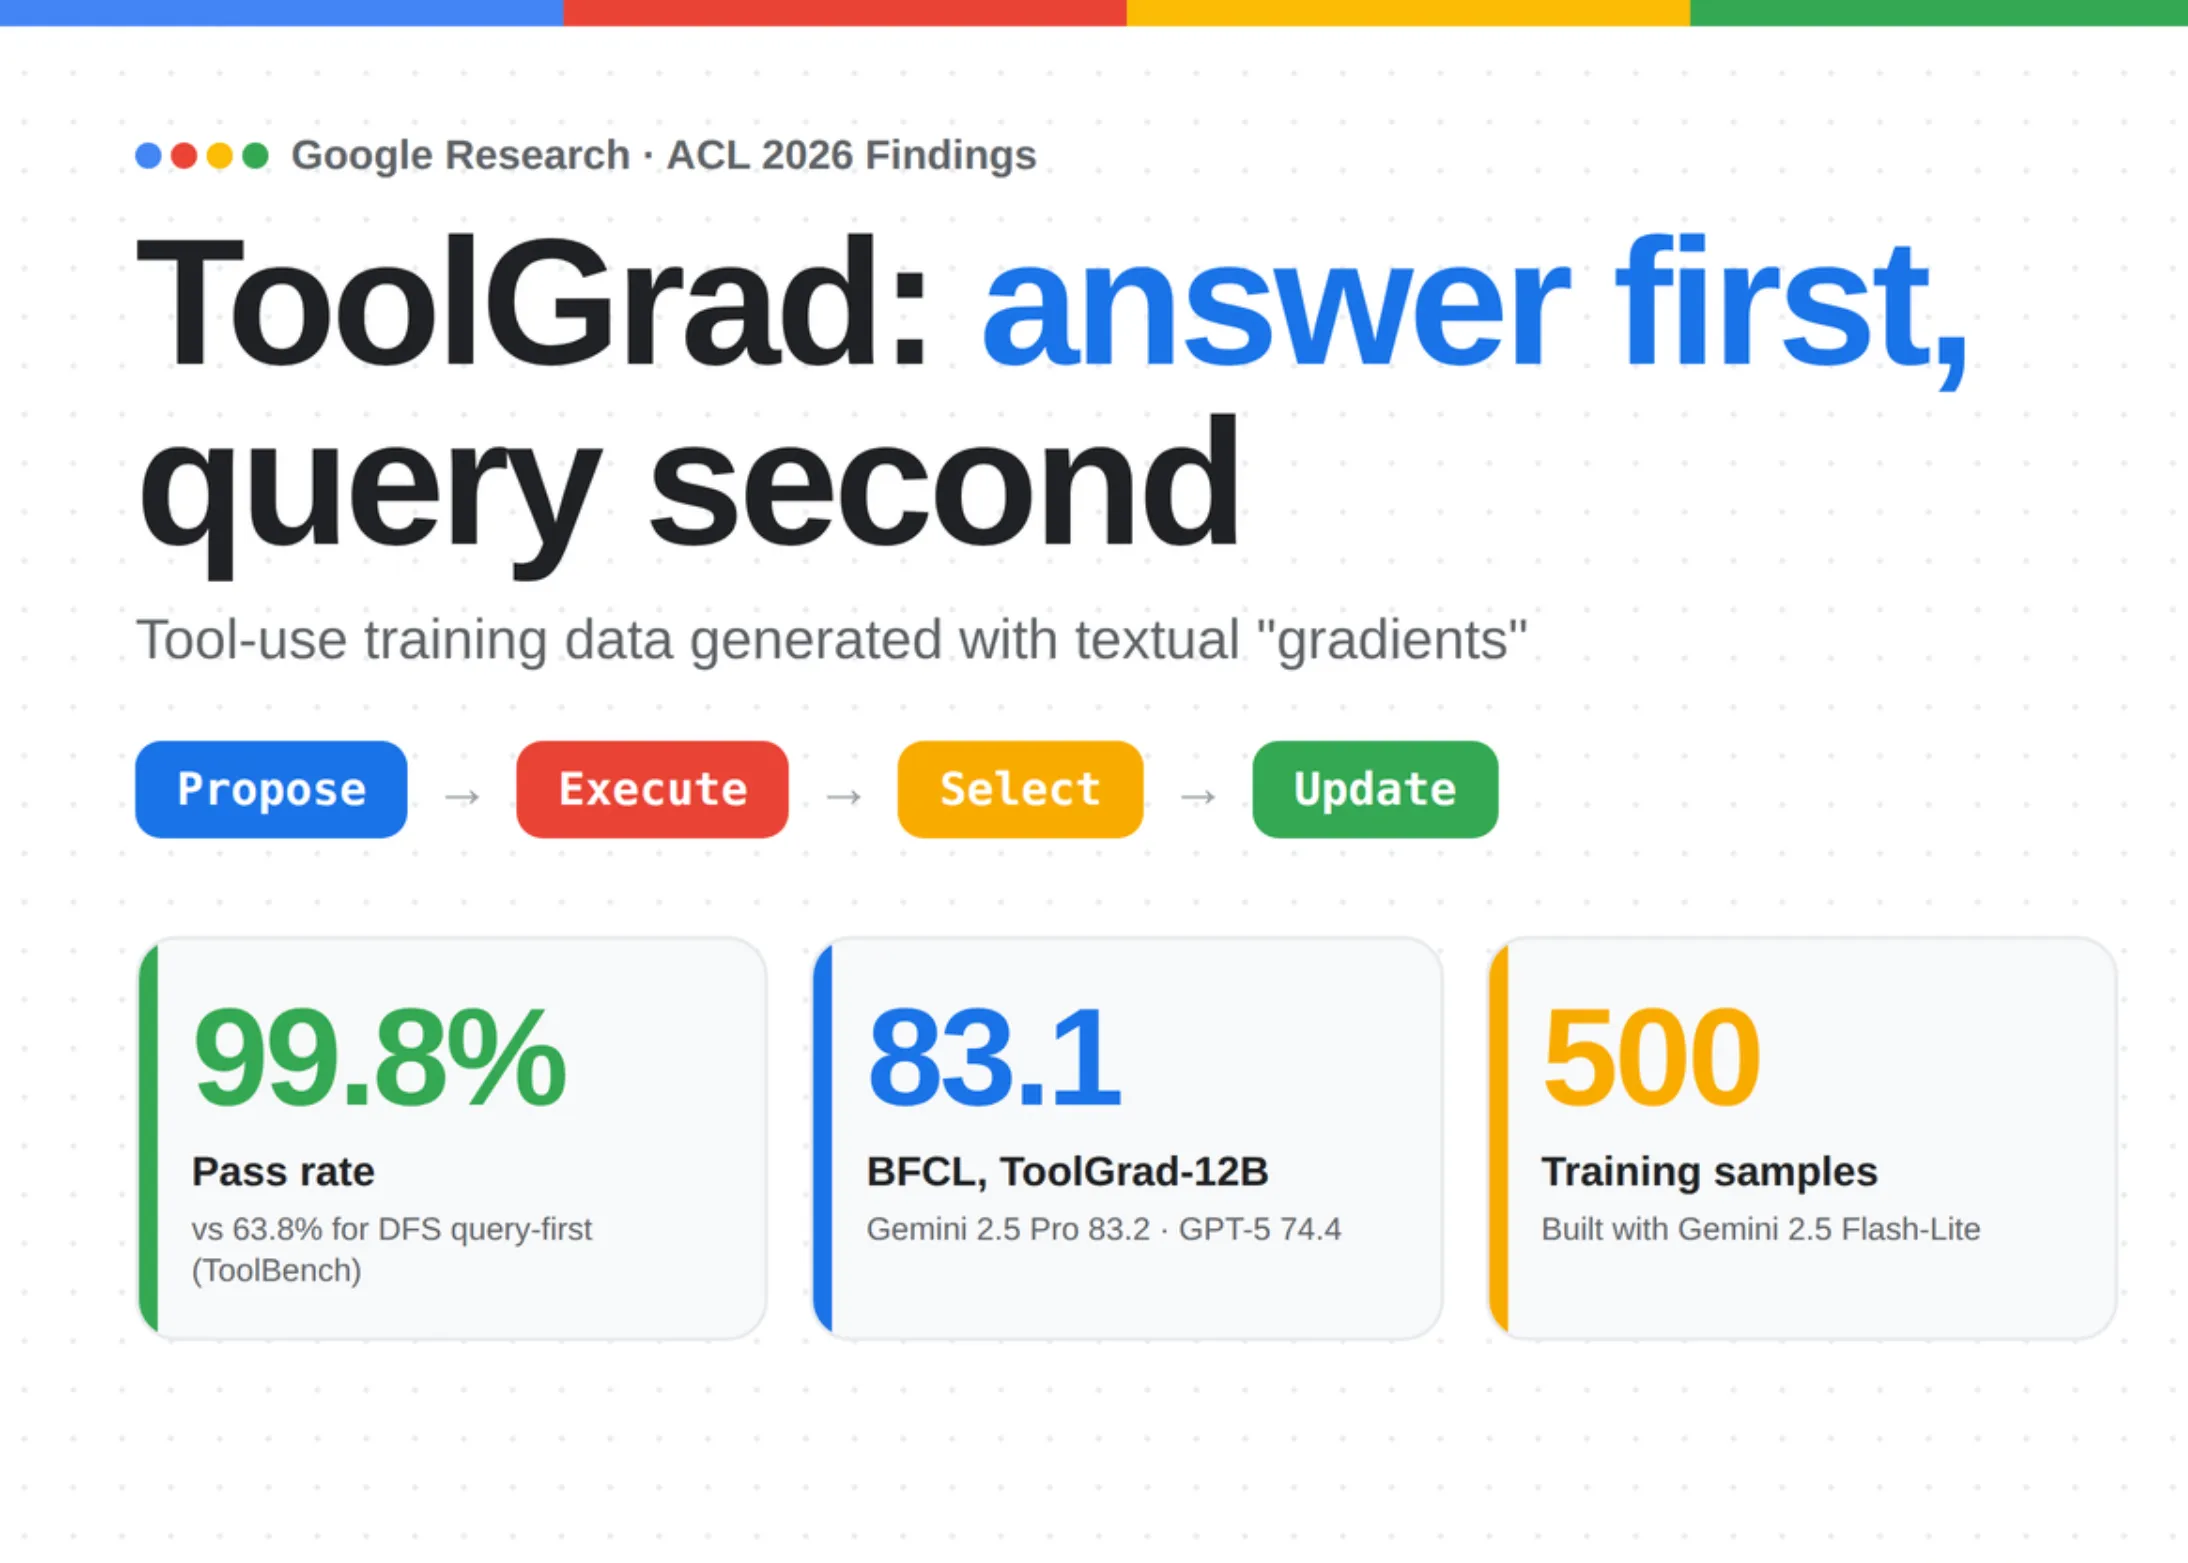
최근 AI 기술 발전은 대규모 언어 모델(LLM)의 기능 확장과 사용자 접근성 증진에 집중되고 있다. 구글 주도 연구팀은 LLM 툴 호출 데이터 생성 효율을 획기적으로 개선한 ‘ToolGrad’를 통해 Gemma-3 모델의 성능을 상위 전용 모델 수준으로 끌어올렸다. 동시에 바이트댄스 등 연구진은 LLM이 스스로 에이전트 실행 환경(하네스)을 개발하고 최적화하는 ‘HarnessDev’ 프레임워크를 공개하며 AI 에이전트의 자율성을 입증했다. 이와 병행하여 … 더 읽기

NVIDIA BioIR, 4,777개 프로테옴 분석 가속; Redis LangCache, LLM 비용 90% 절감 및 15배 속도 향상

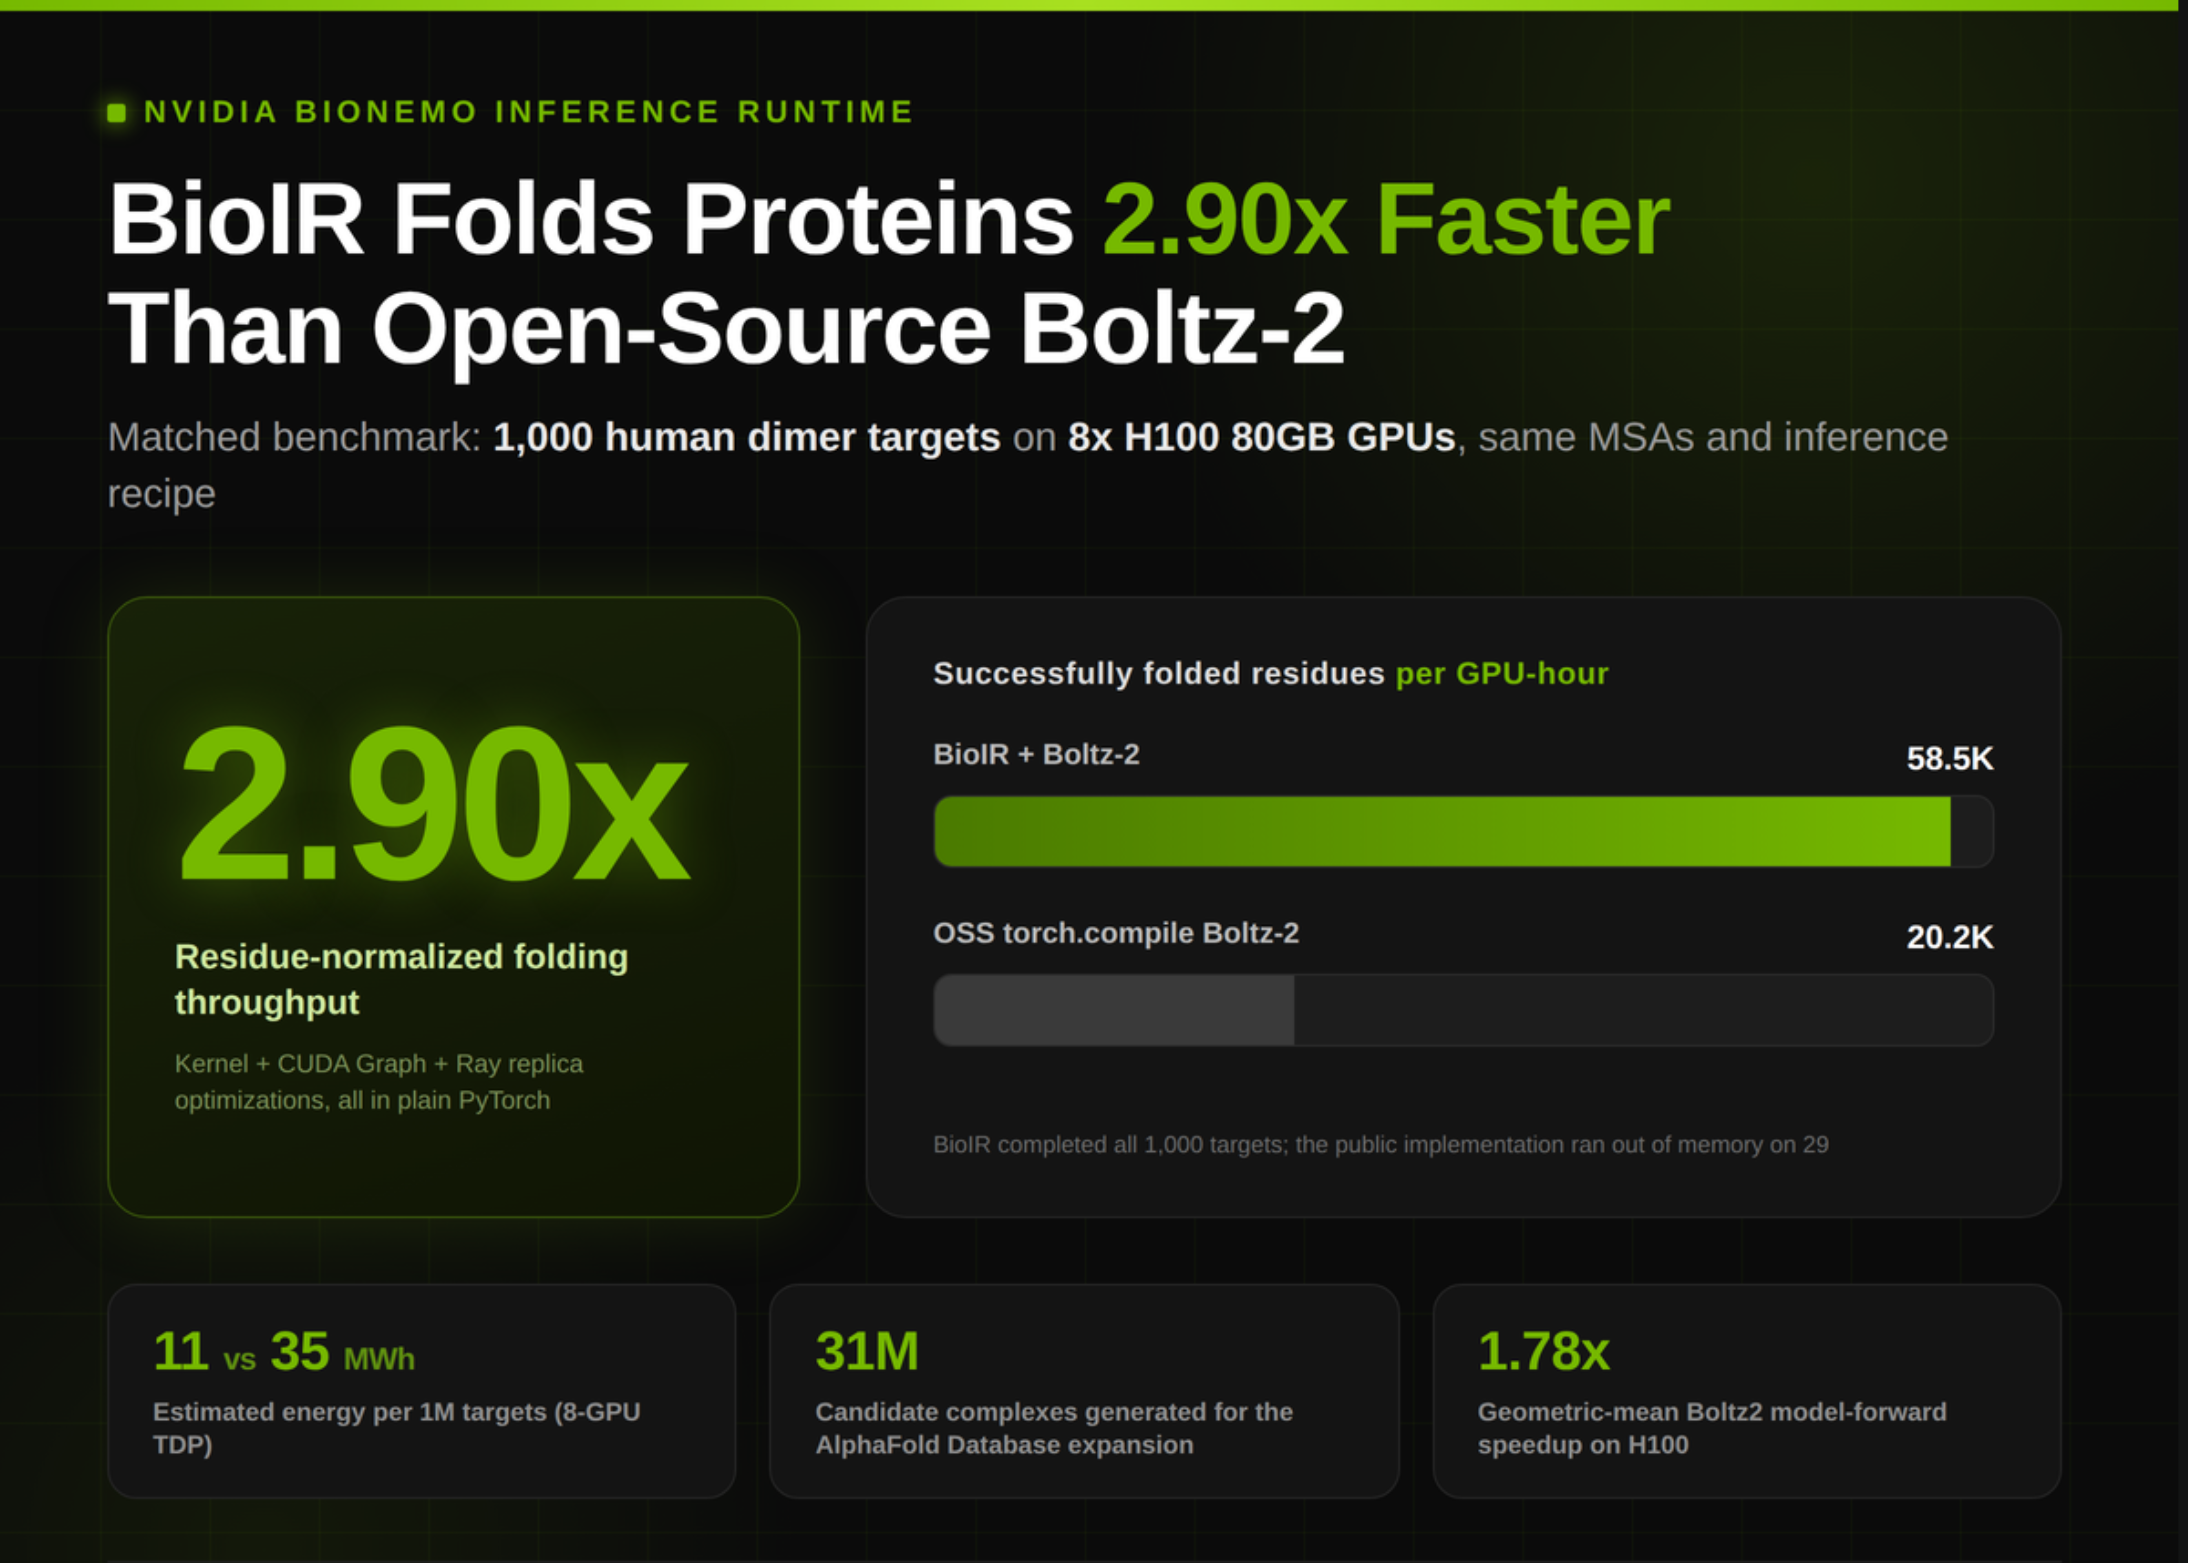
NVIDIA가 생체 분자 구조 예측 워크플로우 가속화를 위한 BioNeMo Inference Runtime (BioIR) 라이브러리를 공개했다. 동시에 Redis는 대규모 언어 모델(LLM) 애플리케이션의 비용 및 응답 속도를 최적화하는 LangCache를 선보이며 AI 모델 배포 및 운영 효율성 증대에 중점을 둔 솔루션들을 제시했다. 핵심 기술 사양 및 성능 분석 NVIDIA BioNeMo Inference Runtime (BioIR)은 단일 타겟을 넘어 프로테옴 규모의 생체 … 더 읽기

DeepSeek-V4.1-Flash, KV 캐시 효율 437배 개선; Apple, 오디오 AI에 Secure Exclave 적용

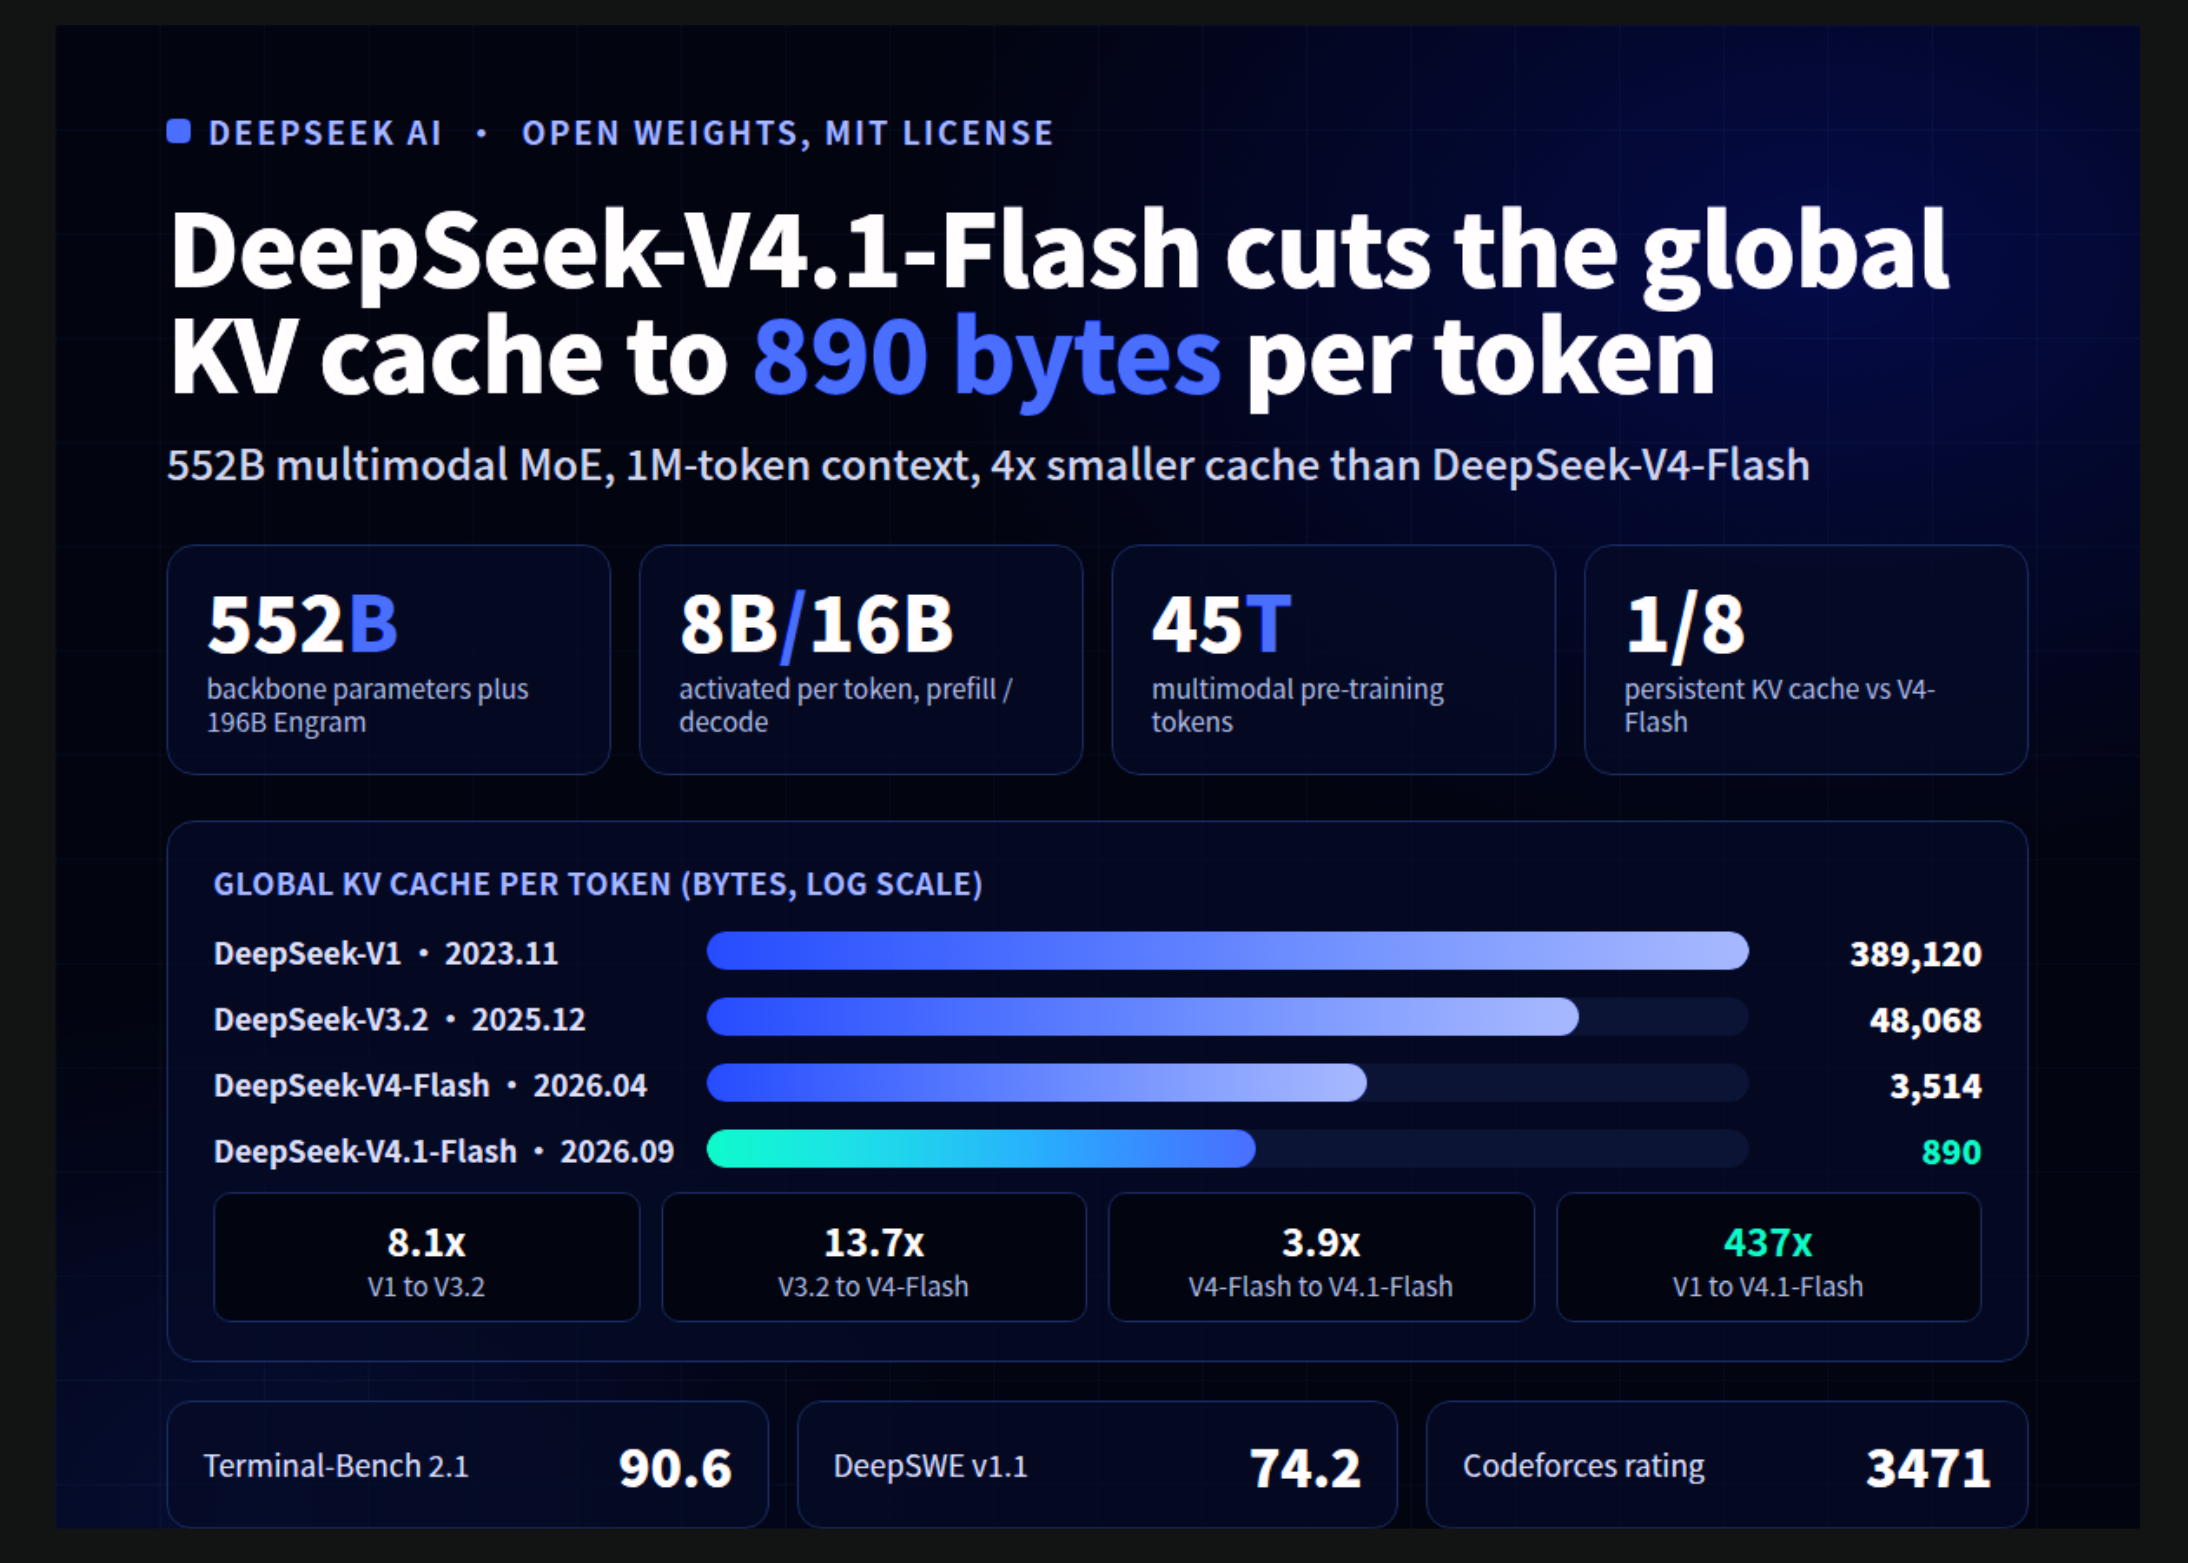
DeepSeek AI가 장기 컨텍스트 대규모 언어 모델(LLM)의 고질적 문제인 KV 캐시 부하를 대폭 줄인 DeepSeek-V4.1-Flash 모델을 공개했다. 동시에 Apple은 WatchOS의 새로운 오디오 AI 기능에 Secure Exclave 기반의 하드웨어 보안 아키텍처를 도입하여 사용자 프라이버시 보호를 강화했으며, Suno는 음원 제작 AI 모델 v6를 출시하며 장르 이해도에서 개선을 보였다. 핵심 기술 사양 및 성능 비교 DeepSeek-V4.1-Flash는 멀티모달 Mixture-of-Experts(MoE) … 더 읽기

OpenAI, ChatGPT Images 2.5 발표로 이미지 생성 지연시간 최대 50% 단축

OpenAI는 최근 자사의 최신 이미지 모델인 ChatGPT Images 2.5를 발표하며, 동시에 두 가지 보조 모델을 API에 추가했습니다. OpenAI에 따르면, 현재 ChatGPT Images 및 GPT-Image API 모델을 통해 매주 30억 개 이상의 이미지가 생성되고 있습니다. 핵심 기술 사양 및 성능 분석 ChatGPT Images 2.5는 이전 버전에 비해 이미지 생성 능력과 효율성에서 개선을 보였습니다. 이미지 생성 지연 … 더 읽기

오픈BMB, 25억 매개변수 LLM 공개; Arm, 신경 가속기 통합 모바일 GPU 발표

오픈BMB는 25억 개 이상의 매개변수를 가진 언어 모델 MiniCPM5-2B를 출시하며 AI 모델 성능 기준을 제시했다. 동시에 Arm은 쉐이더 코어에 신경 가속기를 통합한 Mali G2-Ultra NX GPU를 발표하며 모바일 기기의 AI 및 그래픽 처리 능력을 강화했다. 이들 기술은 AI 에이전트의 자율 기능 확장과 고성능 모바일 컴퓨팅 환경 구축에 기여할 것으로 분석된다. 핵심 기술 사양 및 성능 … 더 읽기